Galleria mappe mentale Introduzione a Hadoop
Il modulo Hadoop può essere suddiviso in MapReduce, HDFS, YARN, Generale, ecc. Seleziona alcuni contenuti per una breve introduzione.
Cosa sono i big data
Una breve introduzione alla home page di Spark sotto Apache
Mappa mentale dei big data
23 punti di conoscenza sui big data e sintesi dell'intervista (1)
Mappa mentale per la visualizzazione dei big data
Capitolo 5, Sviluppo dei prodotti dati
Teoria e pratica della scienza dei dati Capitolo 4
Processo e metodi
Mappa mentale della tecnologia di data mining e analisi
Mappa delle competenze dell'ingegnere dei big data
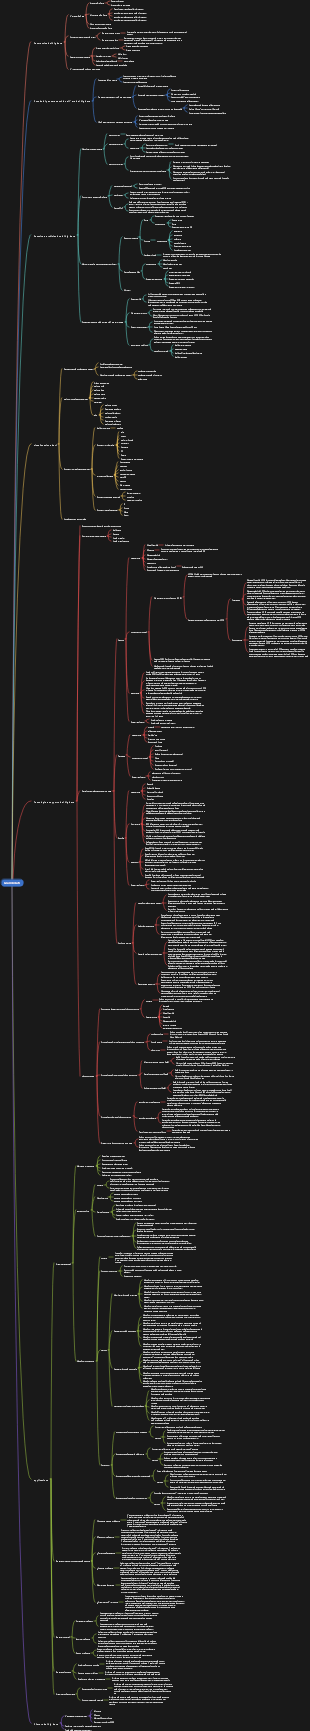
Introduzione a Hadoop
FILATO
primo modulo
Architettura
struttura
Pianificatore di capacità
pianificatore di capacità
Riferimento ai comandi
Parametri di comando
Programmatore della fiera
programmazione equa
Riavvio del ResourceManager
ResourceManagerHA
Disponibilità elevata di ResourceManger
Modello di risorse
modello di risorse
Etichette dei nodi
etichetta del nodo
Attributi del nodo
Proprietà del nodo
Secondo modulo
Proxy dell'applicazione Web
Server della sequenza temporale
servizio di cronologia
NodeManager
Gestore dei nodi
Utilizzo di CGroup
Contenitore sicuro
contenitore sicuro
Sistema di prenotazione
Dismissione graziosa
Ritirati con grazia
Contenitori opportunistici
Cache
Condividi cache
cache condivisa
Vincoli di posizionamento
Posiziona la cache
Generale
Panoramica
Configurazione a nodo singolo
Configurazione del cluster
Impostazioni del cluster
Riferimento al comando
Shell del filesystem
Shell del file system
Specifica di compatibilità
Specifiche di compatibilità
Guida per gli sviluppatori downstream
Guida alla compatibilità dell'amministratore
Classificazione delle interfacce
Specifica del file system
Specifiche del file system
Comune
Mini cluster CLI
Mini-cluster CLI
Coda di chiamate corretta
coda di chiamata corretta
Biblioteche native
libreria nativa
Utente proxy
utente proxy
Consapevolezza del rack
rack consapevole
Modalità protetta
modalità sicura
Autorizzazione del livello di servizio
API del fornitore di credenziali
Tracciamento KMS Hadoop
Tracciamento del KMS Haddop
Guida alla shell Unix
Registro
Riduci mappa
Esercitazione
Compatibilità con 1.x
Shuffle crittografato
Shuffle/Ordinamento collegabile
collegabile
Riproduzione Casuale
ordine casuale
Distribuzione della cache distribuita
Supporto per la cache condivisa YARN
Supporta la cache condivisa YARN
HDFS
Può essere suddiviso in tre moduli principali
Il primo modulo è relativo alle istruzioni per l'utente
Guida all'uso
Guida utente
NomeNodo HA con QJM
NameNode HA utilizzando QJM
NameNode HA con NFS
NameNode HA utilizzando NFS
Nome dell'osservatoreNodo
nodo del nome dell'osservatore
Federazione
federale
VisualizzaFs
Visualizza snapshot FsOverloadScheme
Istantanea
Il secondo modulo è relativo all'editing delle immagini
Visualizzatore modifiche
modificare
Visualizzatore di immagini
Autorizzazioni e HDFS
Quote e HDFS
libhdfs(API C)
WebHDFS(API REST)
HttpFS
Letture locali di cortocircuito
lettura locale di cortocircuito
Gestione centralizzata della cache
Il terzo modulo è relativo alle reti e ai router
Portale NFS
Gateway NFS
Aggiornamento progressivo
aggiornamento progressivo
Attributi estesi
attributi estesi
Crittografia trasparente
Multihoming
multi-homing
Politiche di archiviazione
strategia di archiviazione
DataNodeAdmin
Amministratore DataNode
Federazione dei router
Alleanza dei router
Spazio di archiviazione fornito
Fornire spazio di archiviazione